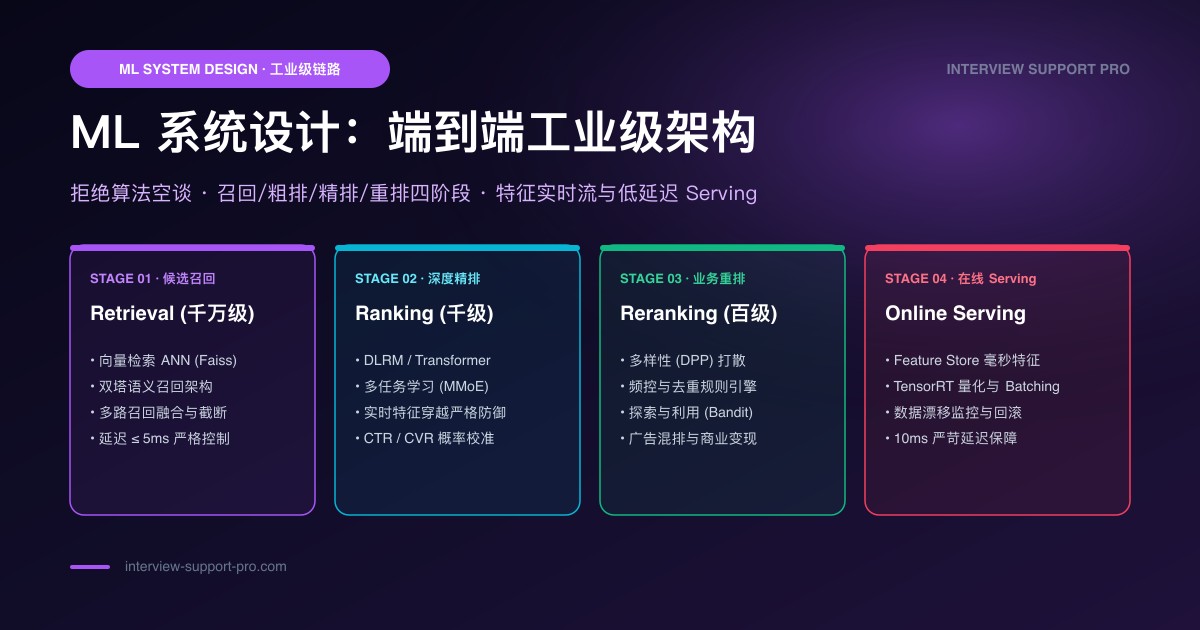
💡 核心要点 (Key Takeaways)
- 先把项目讲成端到端系统,而不是模型论文复述。
- 每道 design 题都要覆盖数据闭环、训练链路、serving 和监控。
- 用 offline-online skew、latency、freshness、rollback 证明工程判断。
免费获取轮次诊断正在备战 SIG MLE 面试?免费获取 SIG MLE 轮次诊断:发你的当前轮次与倒计时,我们先定位卡点,再决定下一步。
为什么只讲模型会失分
近期 MLE 面经里,面试官很少只停留在模型结构。广告排序、推荐、LLM inference、batch service、feature store 这些题都会追问数据从哪里来、多久更新、如何评估、线上出问题怎么发现。候选人如果只讲 loss、architecture 和 metric,很容易被判断为缺少工程落地经验。
一套稳定的回答骨架
先定义业务目标和成功指标,再讲数据与特征,然后讲模型训练和评估,接着讲 serving 架构,最后讲监控、回滚和迭代。每一段都要能回答 trade-off:为什么这样选,代价是什么,坏情况怎么处理。
- 业务目标:优化什么,不能牺牲什么。
- 数据链路:来源、延迟、质量、标签定义、隐私约束。
- 模型链路:baseline、训练、评估、实验、上线策略。
- 线上链路:latency、吞吐、缓存、降级、监控和回滚。
怎么练到可面试状态
不要只看答案。挑一个自己的项目,用同一套骨架重讲三遍:第一遍讲给工程师,第二遍讲给 ML 面试官,第三遍讲给 hiring manager。每次都记录被追问后卡住的点,然后补上数据、指标或系统约束。
常见追问和回答方向
ML System Design 的追问通常不在模型名称上,而在数据闭环和线上风险上。面试官会问:标签延迟怎么办,特征线上缺失怎么办,offline AUC 提升为什么不代表线上收益,模型延迟超预算怎么办,bad case 如何发现和回滚。准备时要把每个追问都接到具体机制。
- 标签延迟:用 proxy label、延迟窗口、回填训练样本和线上观察指标处理。
- 特征缺失:定义 fallback、default value、freshness alert 和特征降级策略。
- 线上收益:用 A/B test、guardrail、分层分析和 bad case review 验证。
- 延迟超预算:区分 precompute、cache、batch、distillation 和候选集缩小。
把项目改写成端到端故事
项目深挖时,不要从“我训练了一个模型”开始。更好的开场是:业务问题是什么,旧系统哪里不够,你负责哪段链路,数据和标签如何定义,为什么选择这个模型,如何上线,线上指标如何监控,失败后如何修复。这个顺序能让面试官先看到 owner 范围,再听模型细节。
💡 SIG 的完整准备路线:OA / Phone / VO 各轮考什么、怎么练,公司攻略页整理成了清单。
SIG 面试全攻略 →练习题清单
建议至少准备四类题:推荐排序、广告点击率、内容安全、LLM inference。每类题都用同一张表复盘:目标指标、数据来源、标签定义、特征 freshness、训练频率、serving 延迟、监控指标和 rollback 条件。练到最后,你应该能在 20 分钟内讲完整主路径,并用 10 分钟处理追问。
45 分钟时间怎么分配
下面是一次 45 分钟自我模拟的建议分配,不代表某家公司固定考法:5 分钟澄清目标与约束,8 分钟数据与特征,8 分钟模型与评估,10 分钟 serving,9 分钟监控与故障处理,最后 5 分钟总结取舍和处理追问。合计 45 分钟;真实面试按邀请和面试官节奏调整。
- 0–5 分钟:目标指标、延迟预算、数据规模与已有资源。
- 5–13 分钟:样本、标签、特征 freshness 和缺失值策略。
- 13–21 分钟:baseline、切分与评估,解释为什么离线提升不等于线上收益。
- 21–31 分钟:召回与排序链路、缓存、超时和成本。
- 31–40 分钟:监控、异常定位、fallback 和恢复。
- 40–45 分钟:总结关键 trade-off,回应追问;中途被打断时保留故障路径,压缩模型细节。
ML 配置系统设计面试题:版本、实验、灰度与回滚
ML 配置系统设计题通常不会单独出现,而是嵌在推荐、排序、LLM serving 或特征服务题里被追问:模型参数、特征权重、策略阈值、prompt 模板、feature flag 这些「配置」由谁管、怎么上线、出错怎么收。这类题考的不是配置中心产品清单,而是你能不能把一个「会变的系统参数」讲成可版本化、可校验、可灰度、可回滚的完整链路。下面是一套端到端 answer path,练的时候按顺序走,最后再补 trade-off 和 follow-up。
- 第一步 requirement clarification(5 分钟定边界):谁写配置——ML 工程师、算法平台、运营还是自动调参系统;谁读配置——线上 serving、离线训练、批处理任务还是人工查询;更新频率——秒级、分钟级还是天级;延迟与一致性要求——推送后多久必须生效、能否容忍短暂不一致、读多写少还是写也频繁。这四个问题直接决定后面 cache 和分发方式怎么选,跳过去直接画组件图会被追问打回。
- 第二步 schema 与 version:配置用结构化格式(JSON / YAML),每个 key 有类型、范围、默认值;整体带 schema version 与配置版本号(单调递增或语义化),旧版本保留可查。写入口做 validation:类型校验、取值范围、依赖 key 是否存在、跨字段约束(如精排模型版本必须匹配对应 feature 版本)。校验失败直接拒绝写入并给出明确错误,坏配置在入口就被挡掉,而不是流到线上。
- 第三步 权限与 audit log:按环境(dev / staging / prod)和配置域(模型参数、业务规则、基础设施)分权限,prod 写操作走审批;每次变更记录 who / when / what / why(diff 前后值),audit log 只追加不修改。面试里主动提这一层,是区分「写过配置」和「管过配置」的关键信号。
- 第四步 分发与读取:每个服务本地 cache 当前生效版本,启动时全量加载;更新走 watch / push(长连接或消息总线)秒级生效,poll(定时拉取 + ETag)作为兜底和最终一致手段,TTL 到期强制刷新防止 cache 与源头漂移。关键路径配置(如降级开关、超时阈值)建议 push 为主、poll 兜底;非关键配置(报表口径、离线参数)poll 就够,别为低频配置上重型 push 通道。
- 第五步 灰度与 experiment override:发布走灰度——先 1% 服务或 1 个机房,盯 guardrail 指标(错误率、延迟 p99、业务核心指标)再逐档放量;实验参数用 override 层叠加在 base config 上,实验结束 override 失效自动回落到 base,避免实验参数残留。override 的优先级(实验 > 灰度 > base)要在设计时讲清楚,被问「两个实验参数冲突怎么办」时能直接答出合并规则。
- 第六步 rollback 与 blast radius:rollback 是一等公民——保留上一稳定版本、版本兼容校验和紧急停止开关。故障正在扩大时优先停止发布、切回已验证版本或启用 fallback;是否分批回滚取决于依赖兼容性与影响面,不能为机械等待灰度而延误止损。配置依赖要显式声明:哪些服务读了这个 key、谁依赖谁,改一个 key 前能列出影响面。bad config blast radius 控制在「灰度范围内」:push 前默认只对灰度分组生效,确认指标无异常再全量,这样坏配置最多影响 1% 流量而不是全网。
- 监控指标(主动报,不等问):配置生效延迟(写入到各服务生效的 p95 / p99)、cache 与源头不一致率(定期采样对账)、validation 拒绝率、灰度期间的业务 guardrail(错误率、延迟、核心转化)、回滚耗时。再准备 5 个 follow-up:① push 通道挂了怎么办(poll 兜底 + TTL,保证最坏情况 N 分钟内仍收敛);② 依赖顺序怎么保证(声明依赖图,按拓扑序推送,或消费端做版本兼容校验);③ 多服务读到不同版本怎么容忍(按配置分级:强一致的关键开关用版本号校验 + 拒绝服务或降级,弱一致的容忍窗口内不一致);④ 实验和灰度同时改同一个 key 谁赢(override 优先级设计:实验层 > 灰度层 > base,冲突时实验胜出并告警);⑤ 配置本身被改错(人为事故)怎么发现(灰度 + guardrail 指标自动熔断 + audit log 定位 + 一键回滚)。
- 一组 trade-off 收尾:push(秒级生效、架构复杂、连接管理成本高)vs poll(实现简单、天然容错、生效有分钟级延迟)。推荐答案是按配置分级:关键路径 push + poll 兜底,低频配置纯 poll;同时强调「单一事实源 + 严格 validation + 版本化存储」是比分发方式更底层的取舍——先把「坏配置进不来」解决,再讨论「好配置多快到达」。
离线线上 gap 怎么讲
先区分问题来源:样本选择偏差、标签延迟、训练与服务特征不一致、时间泄漏和分布变化。检查离线数据时按预测发生的时间还原可用信息,避免把未来标签或特征混入回测。上线前可用影子流量对照输入输出,再按业务风险进行受控实验;影子运行不会直接证明新模型带来真实业务收益。
- 切分:需要时间泛化的任务使用时间切分,记录特征和标签的可用时间。
- 一致性:对同一请求抽样对比训练与服务特征的定义、缺失率和分布。
- 影子运行:新模型不影响用户,只用于观察输出、延迟和错误。
- 上线验证:在适用的实验设计下衡量业务指标,并同时观察延迟、错误率等 guardrail。
练习:把推荐系统方案讲成一次完整决策
这是本站设计的练习,不是真题复刻。假设你为内容推荐首页设计排序系统,目标是增加有价值的阅读,同时控制低质内容与响应延迟。先说明还需要哪些业务信息,再给一个能上线的 baseline,最后讨论模型迭代。练习中的指标和规模由你明确设定,不冒充任何公司的生产数据。
- 需求:怎样定义“有价值”?点击、停留和用户满意度各有什么盲点?
- 数据:展示未点击是否能直接当负样本?新内容没有交互时怎么办?
- 链路:为什么先分召回和排序?流量小、数据少时是否需要复杂模型?
- 上线:特征超时或模型不可用时,如何退回可解释的排序规则?
- 验证:离线指标涨了、线上没涨,你先核对实验、数据还是系统延迟?
- 复盘:录下45分钟回答,只挑最薄弱的一段重讲,不只补模型名词。
自测与模拟复盘:用证据找出薄弱段
每个维度按“未涉及、提到概念、机制完整、能解释替代方案与失败恢复”四档记录。这是自我训练刻度,不是任何公司的评分线。每一档都附一个你实际说出的片段,下一次练习验证同一问题是否改善。
- 目标:能否定义主指标、guardrail 和约束,说明指标冲突如何取舍?
- 数据:能否解释标签、时间切分、特征 freshness 与训练服务一致性?
- Serving:能否给出超时预算、fallback、监控和恢复步骤?
- 表达:被追问后能否回到主链路,而非持续堆组件?
- 需要外部反馈时,可预约 ML System Design 模拟面试,沟通目标岗位、轮次和你最难讲清的一段;材料格式见服务页复盘示例。
📋 资料来源与审校说明
修正45分钟练习安排合计错误、回滚处置与训练服务偏差表述,新增可执行的推荐系统练习与自测清单;补充官方工程资料,区分训练建议和招聘流程。
- Google Rules of Machine Learning:工程参考:baseline、流水线及训练与服务偏差。并非Google招聘题库或评分标准。
- 本站ML System Design训练方案:45分钟练习、推荐系统场景与自测清单为本站编写的教学材料,不作为真实客户案例。
- ML System Design题型路线:按题型选择推荐、RAG与LLM Serving训练方向。
💼 完整服务与价格我们提供 OA 代写($199 起)、VO 辅助($299 起)、VO 代面($499 起) 与 30 分钟免费咨询:按目标岗位、公司与轮次匹配具备相关经验的导师,覆盖 Coding、System Design、ML Design 与 BQ;具体导师与背景以接单前书面确认为准。
