💡 核心要点 (Key Takeaways)
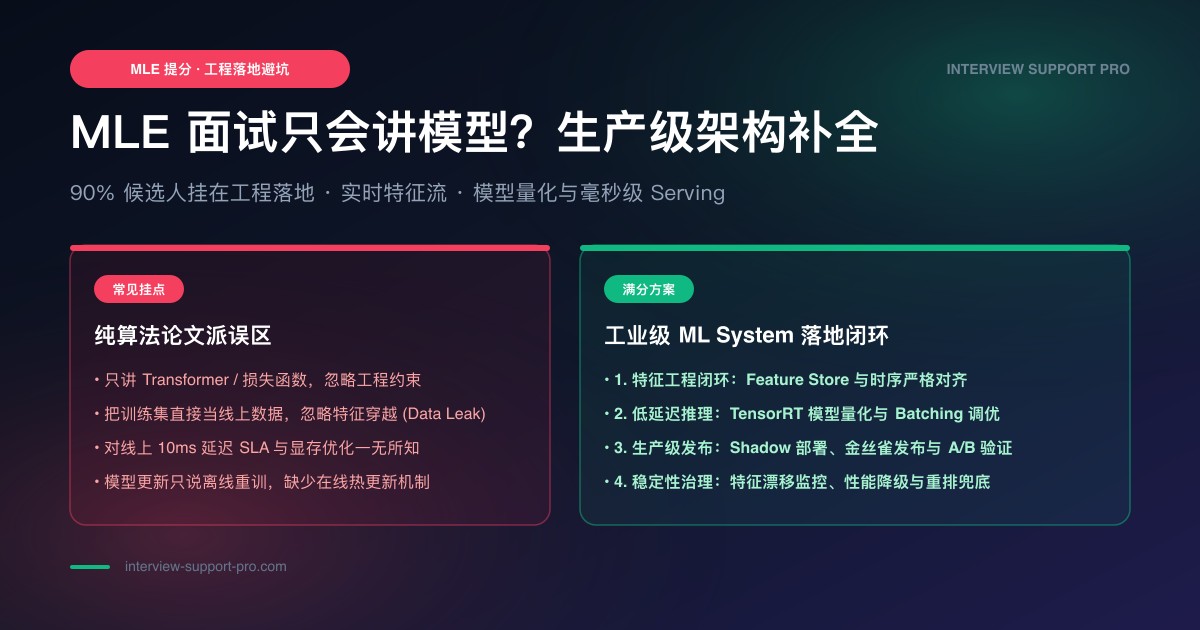
- MLE 面试只讲模型,会暴露工程落地和 owner 意识不足。
- 回答要覆盖数据、标签、特征、训练、serving、监控和 rollback。
- 项目深挖要讲清失败、指标、线上偏差和下一版迭代。
免费获取轮次诊断正在备战 MLE 面试?免费获取轮次诊断:发你的当前轮次与倒计时,我们先定位卡点,再决定下一步。
两种回答的差别
同样是推荐项目,弱回答会说“我用了 embedding + ranker,AUC 提升了”;强回答会先说业务目标,再解释标签怎么定义、特征多久更新、serving 延迟怎么控制、线上坏 case 怎么发现。面试官真正想区分的是你会不会把模型放进产品系统里负责。
模型细节应该放在哪
模型细节不是不能讲,而是不能一上来就讲。先把问题、数据和指标定住,再讲为什么这个模型适合当前约束。否则 loss、architecture、embedding 讲得越多,越容易暴露你没有解释业务目标和上线风险。
- 先讲目标:优化什么指标,不能牺牲什么 guardrail。
- 再讲数据:标签、负样本、延迟反馈、噪声和权限。
- 再讲模型:baseline、特征、训练、评估和 trade-off。
- 最后讲上线:serving、latency、监控、rollback 和迭代。
被追问时怎么补
如果面试官追问“offline metric 好,为什么线上会好”,不要继续解释模型结构。更好的补法是讲实验设计、guardrail、bad case review 和 rollout。如果追问“特征线上缺失怎么办”,就讲 freshness、fallback 和数据质量监控。
一个 15 分钟练习
挑一个自己的 ML 项目,先用 3 分钟只讲模型,再用 5 分钟按目标、数据、模型、serving、监控重讲。最后用 7 分钟追问三个坏情况:数据延迟、线上指标下降、serving 超时。练完后你会很快看到项目叙事缺的是哪一层。
💡 如果目标就是 MLE 岗,按岗位整理的题型分布、轮次路线与准备清单在这里。
MLE 面试辅助 →数据层要讲到什么深度
很多 MLE 候选人知道要讲数据,但只会说“我们收集用户行为”。面试里更有价值的是标签定义、样本偏差、负样本采样、延迟反馈、数据权限和 freshness。比如推荐系统里,点击、停留、购买、hide、report 代表的业务含义不同,训练目标也会不同。
- Label:正负样本如何定义,是否有 delayed conversion 或 noisy label。
- Feature:多久更新,线上线下是否一致,缺失时如何 fallback。
- Split:按时间切还是随机切,如何避免 leakage。
- Quality:如何监控 drift、missing rate、异常分布和坏样本。
上线层要补哪些机制
如果项目已经上线,面试官会关心 serving path。你需要讲清请求如何进入模型服务,候选集如何生成,特征如何取,模型如何打分,结果如何缓存,超时时如何降级,版本如何灰度。即使你不是 infra owner,也要知道自己模型在系统里的位置。
项目深挖的反例
弱回答:“我们换成深度模型后 AUC 提升 3%。”强回答:“旧模型在新用户上效果差,我们发现标签延迟和特征 freshness 是主要问题;先修训练样本窗口和在线特征更新,再上线新模型,用 CTR、D7 retention 和 bad case review 做联合验证,最后灰度到 20% 流量。”差别在于后者体现了端到端判断。
模型版本上线问题怎么答
「新版本模型怎么上线」是高频题,可以按四步流水线回答。第一步回测:新版本在历史数据上跑,和旧版本在同一评估集上对比,说出准入门槛;第二步影子流量:新版本和旧版本并行但不影响真实用户,观察两个版本打分分布的一致性和 serving 延迟——影子流量阶段看的不是精度而是分布差异和延迟,这一步最容易被漏掉,也最值得展开讲;第三步小流量 A/B:预设实验周期和 guardrail 指标,说明晋级或回滚的判断标准;第四步全量并保留旧版本:保留回滚路径,说明触发条件。每一步面试官想听的是准入和退出标准,不是流程本身。如果你的项目没有这条完整流水线,如实说做了哪几步、没做哪几步,再补上你会怎么补。把「没有做过」说清楚,比把没做过的事说成做过安全得多。
做一张一页 model card
面试前为你的代表性项目写一张一页的 model card:一个业务目标、一个主指标加两个 guardrail 指标,数据链路一句(从哪到哪)、模型一句(做什么、为什么选它)、serving 一句(延迟预算、降级方案)、监控一句(报警看哪些指标),最后写一个最大的失败和怎么修的。面试官深挖项目时,拿 model card 当提纲:任何问题先定位到 card 的哪一行,再展开;问题超出 card 范围就明说,再补推理。这张纸有两个用处:第一,它逼你把项目压缩到一页,压不下去的地方就是你没想清楚的地方;第二,它让你在深挖中不丢主线,任何时候都能回到目标和指标上,而不是被追问带着跑进模型细节。
📋 资料来源与审校说明
本文由教研团队重新审校,完善了面试复盘动作与各环节重点说明。 近期教研更新:新增模型版本上线答法、一页 model card 方法两个 section。
- 公开面经信号和岗位能力模型:用于归纳题型和常见追问,不复刻候选人私人信息。
- Interview Support Pro 模拟面试复盘:用于总结候选人在表达、项目深挖和 follow-up 中的高频卡点。
💼 完整服务与价格我们提供 OA 代写($199 起)、VO 辅助($299 起)、VO 代面($499 起) 与 30 分钟免费咨询:按目标岗位、公司与轮次匹配具备相关经验的导师,覆盖 Coding、System Design、ML Design 与 BQ;具体导师与背景以接单前书面确认为准。
