💡 核心要点 (Key Takeaways)
- Snowflake 数据建模题要从业务查询模式出发,而不是先画一堆表。
- Warehouse 设计要讲 raw、staging、mart、SCD、增量、回填和成本控制。
- Metrics Layer 要覆盖口径治理、版本、血缘、权限和下游变更通知。
免费获取轮次诊断正在备战 Snowflake Data Engineer (DE) 面试?免费获取 Snowflake Data Engineer (DE) 轮次诊断:发你的当前轮次与倒计时,我们先定位卡点,再决定下一步。
Data Modeling 面试看什么
Snowflake 相关面试常把 SQL、warehouse、pipeline 和数据建模连在一起问。面试官想看你是否能从业务实体和查询模式出发,设计出可维护、可回填、可解释、成本可控的数据模型。
Warehouse 三层怎么讲
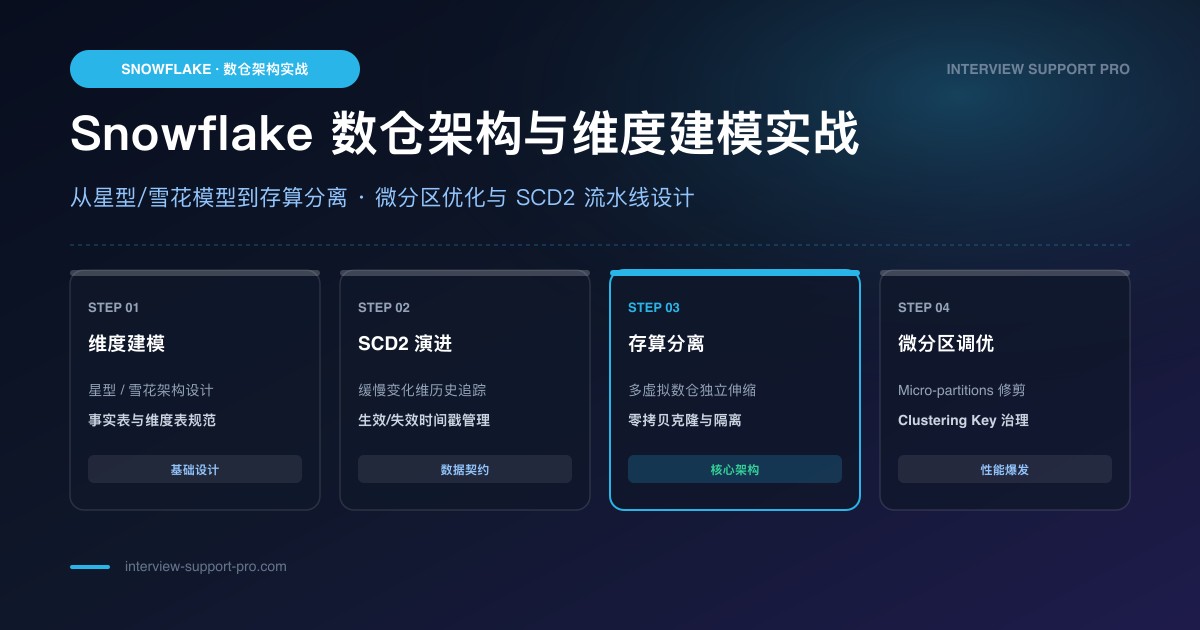
一个稳定回答可以从 raw、staging、mart 三层开始。Raw 保留原始数据和审计字段,staging 做清洗、去重和类型标准化,mart 面向业务查询做事实表、维表、宽表或指标表。
- Raw:source id、ingestion time、schema version、原始 payload。
- Staging:dedup、type casting、null handling、CDC merge。
- Mart:fact、dimension、bridge table、aggregate table。
- 治理:lineage、owner、SLA、quality check、access policy。
SCD 和 Schema Evolution 怎么答
慢变维、字段新增、字段语义变化和 source schema 漂移是高频追问。回答时要说明 valid_from / valid_to、current flag、版本字段、兼容策略、历史回放和下游通知。
💡 Snowflake 的完整准备路线:OA / Phone / VO 各轮考什么、怎么练,公司攻略页整理成了清单。
Snowflake 面试全攻略 →Metrics Layer 的关键点
指标层不是多建几张汇总表,而是统一口径。要讲 metric definition、dimension、filter、owner、version、权限、缓存、dashboard / API 消费,以及口径变更后的回填和公告流程。
查询成本和性能怎么补
Snowflake 候选人要能解释 partition pruning、clustering、materialized view、warehouse size、缓存、扫描列裁剪和 query profile。成本控制不是最后附加项,而是数据平台设计的一部分。
Warehouse 设计轮怎么组织回答
设计轮很少直接问'设计一个三层模型',通常是'公司营收数据散在 5 个系统里,给财务团队设计 mart 层'这类题。按五步答:先问业务问题,明确谁在用、多久看一次、最重要的 3 到 5 个查询是什么;再从查询倒推 grain 和关键实体,确定事实表的粒度,grain 一定要说成'一行等于一笔什么'的句式,不能含糊;然后映射到 raw、staging、mart 三层,说清每层负责什么、质量检查放在哪一层;第四步讲接入和回填,增量怎么算、历史怎么回填、一致性怎么校验;最后收在成本、权限和监控上。关键原则是每张表都要能指回一个业务查询。面试官最常追的就是'这张表为什么必须存在,它服务哪个查询'。答不出来的表,宁可砍掉,也别为了显得完整而留着。五步讲完之后,准备三个高频收尾追问的接法:业务方下周要加新维度怎么办、上游系统下线了历史数据怎么处置、mart 表涨到一定规模查询变慢怎么办,每个用两句话给方向。讲回填校验时给出具体做法:新旧数据按关键指标对总量和行数,差异在可接受范围内才算通过,而不是说'跑完对比一下'。练习时准备 2 到 3 个自己项目里的真实查询场景,把它们当题目反复走这五步,直到每步能脱口而出。
数据权限和跨团队共享怎么答
权限是平台类题的高频追问,准备一个四层回答:第一层对象级权限,哪个团队能看哪些表和视图;第二层行列级控制,比如销售只能看本区域数据、敏感字段做脱敏,讲的时候给一个具体规则例子,比如金额字段只保留后四位展示;第三层治理机制,最小权限授予、定期访问审计、变更留痕;第四层跨团队共享,用 share 或统一语义层代替各团队复制表,并说明上游变更时怎么通知下游。回答时不要只列功能,要挂到场景上,比如'财务和产品对同一个指标口径不一致时,谁有最终解释权,系统怎么强制'。这类回答展示的是你理解治理是组织问题,不只是数据库配置问题。再准备一个反面案例:无治理导致的重复建设和口径打架,说明你见过混乱长什么样。练习方法:从自己公司挑两个真实的权限需求,比如'新团队接入只能看脱敏数据'和'审计要求导出留痕',按四层各答一遍,答不出第四层就说明共享机制这块要补。最后补一句成本视角:权限和共享本身也有计算开销,定期审计时可以顺带清理长期不用的账号和 share,展示你有成本意识。被追问具体实现时,落到 tag、masking policy、share 这三个名词上就够了,不要展开成产品文档。
📋 资料来源与审校说明
首次发布,提供面试准备方法、题型拆解和复盘建议。 2026-08-22:新增「Warehouse 设计轮怎么组织回答」「数据权限和跨团队共享怎么答」两个 section,补充可执行备考方法。
- 公开面经信号和岗位能力模型:用于归纳题型和常见追问,不复刻候选人私人信息。
- Interview Support Pro 模拟面试复盘:用于总结候选人在表达、项目深挖和 follow-up 中的高频卡点。
💼 完整服务与价格我们提供 OA 代写($199 起)、VO 辅助($299 起)、VO 代面($499 起) 与 30 分钟免费咨询:按目标岗位、公司与轮次匹配具备相关经验的导师,覆盖 Coding、System Design、ML Design 与 BQ;具体导师与背景以接单前书面确认为准。
