💡 核心要点 (Key Takeaways)
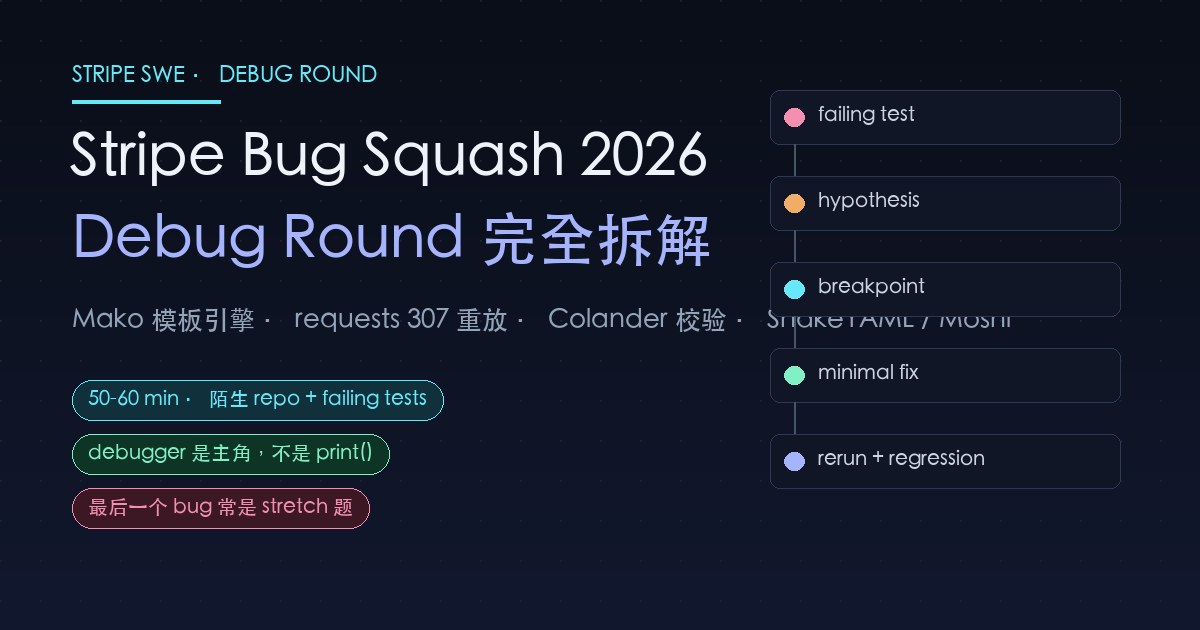
- Bug Squash 是 50–60 分钟的定位赛:陌生 repo + 已植入的 bug + failing tests,考的是复现、假设、debugger 验证、最小修复、回归这套过程。
- 最后一个 bug 常是 stretch,同学提供的面经里没修完仍有正面反馈;把判断过程讲清楚,比多改一处代码更值钱。
- Python 线优先练两个 repo:Mako(AST visitor / file-directory / comment-control line)和 requests 307(seekable stream 的 cursor 被消费)。
- requests 307 的关键不是 seek(0):prepare 阶段记录 body_position = stream.tell(),重发前 seek 回该位置,才能保住调用方已经读过的偏移。
- Java 线优先 SnakeYAML 与 Moshi / Jackson,其次是 Failsafe;Preact 和 ML Bug Squash 只和前端 / MLE 岗位相关。
免费获取轮次诊断正在备战 Stripe SWE 面试?免费获取 Stripe SWE 轮次诊断:发你的当前轮次与倒计时,我们先定位卡点,再决定下一步。
这篇适合谁
如果你收到的是 Stripe 的 Bug Squash(也叫 Debug Round / Debugging Round),这一轮和普通 coding 的差别比想象中大:不是从零写代码,而是给你一个以前没见过的、接近真实开源项目规模的 repository,里面已经植入若干 bug,并附上 failing tests,要求在 50–60 分钟内尽可能多地定位并修掉。这篇按「轮次机制 → 固定解题流程 → 高频 repo 逐个拆 → 备考优先级 → 两套 Mock」的顺序展开。
先说口径:下面所有 repo 与 bug 细节都来自 2025–2026 年同学提供的面经信号、公开复现仓库和候选人复盘。Stripe 官方从未公布固定题库,同一类 repo 会有版本轮换,题目里的 bug 也可能被替换,所以请把它当作备考方向,不要当成背下来就能过的答案。
站内分工:《Stripe 面经 2026:SWE 全流程》管 OA / Phone / VO 的整体结构与各轮题型;《Stripe Debug / Integration:Follow-up 怎么不改崩》管 Debug 轮的代码结构与 follow-up 应对;这篇只聚焦 Bug Squash 这一轮本身怎么打。
Stripe Bug Squash 到底怎么面
同学提供的面经里的形态高度一致:给一个陌生 repo 和一组 failing tests,限时 50–60 分钟,让你从失败的测试出发定位并修复植入的 bug。repo 的选择偏「成熟的开源库 + 若干相对独立的 bug」,所以几乎不可能靠通读代码取胜,只能靠定位方法。典型循环是:跑测试 → 看 failure / stack trace → 定位调用链 → 提出 hypothesis → debugger 验证 → 最小修改 → 重跑测试 → regression check → 下一个 bug
多个面经都强调同一件事:面试官考的不只是「最后修了几个」,而是你如何在陌生代码库里系统性地定位问题。还有两个现场约束值得提前知道:搜索引擎和官方文档通常可以查,但 AI / Cursor 这类代码补全一般不允许,所以别把习惯建立在依赖补全上。
准备上最容易吃亏的一点是:必须熟练使用真正的 debugger,而不是只会 print。面试前请确认本地 IDE 能完成这六件事:
- 安装依赖:能按 repo 的 requirements 或 build 文件把环境跑起来。
- 跑测试:能跑全量、也能只跑单个测试方法与单个测试文件。
- 打 breakpoint:在可疑代码行停下来,而不是靠加日志重跑。
- step into / step over:能跟着调用链进出函数,逐层缩小范围。
- 看 call stack:能读出「谁调用了这里、参数是什么」。
- inspect variables:能在断点处查看对象状态,尤其是 stream、cursor、累加器这类可变状态。
Debug Round 的评分信号:不一定要全部修完
这一条能直接改变现场策略。同学提供的面经多次显示:最后一个 bug 往往是 stretch 难度,修不完并不决定评价。有人是「Bug 1 完成、Bug 2 完成、Bug 3 没做完」,也有人是「Bug 1、Bug 2 解决,Bug 3 找到了 root cause、准备动手时超时」,两者都仍然拿到「这一轮表现很好」的反馈。
所以目标不该是「尽快改代码」,而应该是:让面试官非常清楚地看到,你能像 senior engineer 一样系统 debugging。具体做法是把复现、假设、验证、根因、最小修复、回归这几步全部说出来,让判断过程可见。宁可少修一个 bug 但每一步都有依据,也不要静默地东改西改——后者恰恰是面试官最怕在真实工作中遇到的 debug 方式。
现场固定流程:11 步练成肌肉记忆
建议把下面这套流程练到不需要思考,每一步都尽量配一句口头说明,让面试官跟得上你的判断。流程本身不复杂,难的是在时间压力下不跳步。
- 1. Reproduce:先运行 failing test,确认失败现象能稳定复现。
- 2. Understand expected behavior:明确 expected vs actual,先别急着看实现。
- 3. Narrow scope:从 stack trace / failing assertion 往回找,逐层缩小调用链。
- 4. Form hypothesis:说出「My current hypothesis is ...」,把猜测变成可验证的命题。
- 5. Validate:用 breakpoint、inspect variable、call stack 去证实或推翻假设。
- 6. Root cause:动手前先明确说「I think I found the root cause.」
- 7. Minimal fix:不重构、不顺手优化,只做最小安全修改。
- 8. Run targeted test:先只跑这一个 test,确认从红变绿。
- 9. Run related tests:跑邻近测试,防止 regression。
- 10. Explain:解释 bug 为什么会出现、为什么这个 fix 正确、边界在哪里。
- 11. Next bug:确认上一个修复稳定后再进入下一个,并在心里记下已修的 root cause。
现场话术:把思路讲出来
Bug Squash 的表现分有相当一部分来自沟通。下面这些句式几乎可以直接用,重点是让面试官随时知道你在验证什么、结论从哪来。
- 刚拿到题:“I’ll first reproduce the failure so I understand the exact expected and actual behavior.”
- 看 stack trace:“Rather than reading the entire repository, I’m going to start from the failing test and trace this execution path.”
- 发现可疑变量:“This value looks suspicious. Before changing anything, I want to verify where it was initialized.”
- 形成假设:“My current hypothesis is that the stream is consumed during the first request and isn’t rewound before the redirect.”
- 找到根因:“I think I found the root cause. Let me verify it with the debugger before making the change.”
- 准备修改:“I’ll make the smallest possible fix first and rerun the targeted test.”
- 修复通过:“The failing case passes. Before moving on, I want to run the neighboring tests to make sure I didn’t introduce a regression.”
第一优先级:Mako 模板引擎
Mako 是目前同学提供的面经里出现频率最高的一类。题面通常就是:给你一个被修改过的 Python Mako template engine repo,里面植入几个彼此相对独立的 bug,让你根据 failing tests 一个个修。因为 Mako 是 Python 模板引擎,这题同时考 Python、AST 和「陌生库定位」三件事。同学提供的面经里反复出现三类 bug:
- AST expression generation / visitor:出现过非常具体的描述「Bug 1: Build the visit_arg function」——AST traversal 或 expression generation 的代码里,某种 argument 节点没有对应的 visitor,导致生成结果不正确。典型调用链是 failing test → template compile → AST parsing → visitor dispatch → 某个 AST node → 对应的 visit_xxx 缺失或行为错误。
- template lookup(file vs directory):某个 lookup / path 逻辑拿到 path 之后直接当成 file / template 处理,但它其实可能是目录。同学提供的面经里的修复方向就是在交给后续逻辑前先确认
os.path.isfile(path);真正考的是能否从 failing lookup test 快速 trace 到 filesystem / path 分支。 - control statement / comment 处理:常见形态是 ControlLine 相关的检查对普通注释处理正常,但对 comment-only line 或某类特殊 control line 行为异常,属于解析阶段的边界问题。
Mako 的准备重点:visitor pattern 与模块地图
Mako 的 failure 归纳起来就是上面三类:AST expression generation、template lookup、control statement / comment handling。难点从来不是代码量,而是要快速理解 visitor pattern 和 AST traversal——一旦看懂「节点类型 → dispatch 到 visit_xxx → 生成代码」这条主链,剩下就是读具体节点实现。
建议至少知道这几个模块各自在干什么(不需要完整读项目):
mako/lookup.py:模板查找与缓存,file / directory 那类 bug 的常见落点。mako/lexer.py:把模板文本切成节点,control line、tag、comment 的处理都在这一层附近。mako/codegen.py:从模板解析树生成 Python 模块代码,visitor 与 expression generation 的主战场。mako/pyparser.py:解析模板里嵌入的 Python 表达式,visit_arg这类 AST 节点问题的直接相关方。mako/parsetree.py:模板解析树的节点类型定义,用于确认「这个节点应该由谁处理」。
Mako 的解题节奏:不要一直跑全量 suite
全量 pytest 的输出会把你淹没,而且每次重跑都要等几十秒。同学提供的面经里的推荐节奏是:把 failing tests 按 root cause 分组,选定一个 test 单独跑,debug、fix、跑相关 tests,最后再跑全量确认。同学提供的面经里出现过一次 11 个 failing tests 的场景,而它们往往只对应 3 个左右 root cause——先聚类、再逐个打,比按测试文件顺序打要快得多。
典型命令:
pip install -r bugsquash-requirements.txt:先把依赖装好,确认本地能跑测试。python -m pytest test/ -v:第一遍拿全貌,看清哪些失败、失败信息长什么样。python -m pytest test/test_lookup.py::TestClass::test_name -v:之后只跑当前这个 test,快速迭代。- 修完后跑相邻测试文件,最后再跑一次
python -m pytest test/ -v确认没有引入 regression。
第二优先级:Python requests — HTTP 307 与 seekable body 重放
这是 2026 年最值得重视、公开细节也最完整的一类。场景是:POST 请求收到 HTTP 307 Temporary Redirect 后,必须把同一个 method、同一份 body重新 POST 到新 URL。307 的语义就是「method 和 body 都不变地重放」,这点和常见的 301/302 实现不同,也和 303 明确不同——303 会要求客户端改用 GET。
公开的题目描述和复现里,测试大概会覆盖三种 body 形态:字符串 data='test'、可 seek 的 data=io.BytesIO(b'test'),以及一个更刁钻的变体:调用方在传入 stream 之前已经消费了一部分字节,比如先 data.read(5),那么本次请求真正需要发送的只是剩下的 b' world',redirect 之后也必须仍然只发 b' world',而不是整段重来。
requests 的 root cause:cursor 被消费,而不是「忘了 rewind」
把流程摊开就很清楚:第一次请求时 BytesIO 的 cursor 是 0,send 内部把 stream 读完,cursor 直接到 EOF;此时收到 307,requests 需要重发 body,却继续用同一个 stream 对象去 read——cursor 已在末尾,实际可用字节数是 0,于是可能出现 expected Content-Length = 4 / actual bytes available = 0 这类不一致,最终表现成 timeout,或者发出去一个错误的 body。
最容易想到的修法恰恰是错的:直接 stream.seek(0)。因为调用方传入 stream 时,cursor 本来就可能不在 0。上面 data.read(5) 的例子就是 cursor 停在 5,无脑 rewind 到 0 会把 b'hello world' 整段重发,而正确行为是只重发剩余的 b' world'。
正确思路是记录初始 stream position,而不是无脑 rewind 到 0:
- prepare request 阶段先记下位置:
body_position = stream.tell。 - 正常发送请求,此时 stream 会被读到 EOF,cursor 状态已经改变。
- 收到 307,进入重放 body 的分支。
- 重发前用
stream.seek(body_position)回到调用方的起始偏移,而不是seek(0)。 - 用同一 method、同一份剩余 body 重发,并保证 Content-Length 与实际发送字节数一致。
💡 Stripe 的完整准备路线:OA / Phone / VO 各轮考什么、怎么练,公司攻略页整理成了清单。
Stripe 面试全攻略 →requests 这题同时考了七八件事
这题区分度高,是因为一个最小修复背后串起了整条链路。修完之后如果能把下面每一条都讲清楚,这一轮基本就稳了:
- HTTP 307 语义:method 与 body 必须原样重放,不能退化成 GET。
- 可 seek 与不可 seek stream 的差异:BytesIO 能 seek,socket-like 流不能,两者的降级策略不同。
- stream cursor 与 mutable state:谁消费了 stream、消费到哪,是这题真正的根因。
- Content-Length 与实际可用字节数不一致,会导致请求挂起或发出错误的 body。
- 读懂库代码:request 准备、redirect 处理、body 重放分支分散在不同模块里。
- 回归测试:修完要确认其他 redirect(301 / 302 / 303 / 308)路径没有被带崩。
- 公开复现信号:GitHub 上有人专门复现 Stripe debugging round,其中 Python 候选人遇到的是
test_HTTP_307_ALLOW_REDIRECT_POST_WITH_SEEKABLE这类 failing test,说明 requests 不是偶发题,而是会轮换复用的 debugging repo。
第三优先级:Colander 校验库
2026 年出现过 Python Colander validation library 的 Bug Squash,通常会涉及约 3 个 bug。核心场景是多条 validator 各自产生 validation error,再被 aggregate 成结构化结果,最后通过 asdict 输出嵌套的 error dictionary;bug 往往就藏在这条聚合链路上——某一层 error 丢失、key / path 传播断掉,或者嵌套结构里某一级没有被正确展开。建议重点理解这几个概念:
- validation tree:schema 的嵌套结构与校验顺序。
- exception hierarchy:Invalid 这类异常的父子关系与聚合语义。
- error aggregation:多个 error 怎么合并,顺序与去重如何处理。
- nested dictionary:
asdict输出的层次结构长什么样。 - path / key propagation:出错字段的路径如何一路传到最外层。
Java 线:SnakeYAML / Moshi / Jackson / Failsafe
如果面试可以选 Java,高频 repo 和 Python 线完全不同。
SnakeYAML(2025–2026 多次出现,优先级最高):同学提供的面经里有一个很具体的例子——解析 flag: On 时没有正确得到 Boolean.TRUE;另一些 bug 会落在 CSV parsing 或 parser / resolver 逻辑上。复习重点是 YAML scalar、resolver、implicit type、boolean parsing、token、scanner、parser、constructor。这类题的共同点是:bug 不在「解析器整体」,而在某一类 scalar 的隐式类型推断。
Moshi / Jackson(JSON,长期高频):长期模式非常统一——Java 成熟 parsing library + failing unit test + trace parser / deserializer + minimal fix。要熟悉 parser、adapter、deserializer、null handling、type conversion、nested object parsing 和 regression test。JSON 库的 bug 常常表现为「某个字段为 null 或类型不匹配时,行为和预期不一致」。
Failsafe(retry / failure handling,出现频率较低):debugging 点集中在 retry count、attempt number、exception propagation、predicate、delay / backoff、success / failure listener、state reset。经典形态是 off-by-one 与状态没重置:重试次数差一次,或者上一轮的失败状态没清掉,导致后续 attempt 行为漂移。
前端和 MLE 的版本
这两类只在对应岗位出现,普通后端 SWE 可以跳过。前端候选人出现过修改版 Preact repo 的 Bug Squash,如果面的是后端 Staff / Senior,一般不用重点准备。MLE 则是另一套题:给一个 trained model 加 code package,里面植入多个 bug,需要 debug model / data / metric pipeline,同学提供的面经里出现过 NaN、distribution、ROC-AUC 相关的问题。
备考优先级:按语言选 repo
把上面的信号压缩成一张优先级表(基于同学提供的面经出现频率,不代表官方题库)。如果可以选 Python:
- ★★★★★ Mako:必练。三类 bug 都要能独立定位,尤其 AST visitor 与 template lookup。
- ★★★★★ Python requests 307:必练。核心是 seekable stream 的 cursor 语义与 body 重放。
- ★★★★ Colander:至少熟悉。重点在 error aggregation 与
asdict的嵌套结构。 - ★★ Failsafe:有时间再练(如果面试允许选 Java,它的优先级会上升)。
如果选 Java:优先级怎么排
Java 线的顺序是:
- ★★★★★ SnakeYAML:必练。scalar 的隐式类型推断是重点,例如
flag: On的布尔解析。 - ★★★★★ Moshi / Jackson:必练。parser、deserializer、null handling、type conversion。
- ★★★ Failsafe:推荐练。off-by-one 与 state reset 是高频卡点。
其他岗位的版本
Preact 只有前端候选人需要准备;ML Bug Squash 只有 MLE 需要准备。普通 SWE 不需要在这两类上花时间。
两套 Mock:45–60 分钟内稳定做下来
如果面试可以选 Python,最值得做的就两套。目标不是「做对」,而是在陌生代码里把定位过程讲清楚。
Mock 1:Mako
- 目标:3 个 failing tests,分别指向 AST visitor、file / directory 处理、comment / control-line parsing。
- 练:pytest 单测运行、pdb 或 IDE debugger、stack trace 阅读、陌生代码导航、最小 patch。
- 检查点:能否在动手改代码前说出 root cause,并在修完后主动跑邻近测试。
Mock 2:requests 307
目标链路:
- POST body → seekable stream → HTTP 307 → redirect replay → 保留调用方的原始 cursor 位置。
- 练:stream state、request 准备阶段、redirect 流程、body rewind、regression test。
- 检查点:能否解释清「为什么 seek(0) 是错的」,并用
data.read(5)这样的用例证明。
最后的实战建议
如果能把上面两套 Mock 在 45–60 分钟内稳定做下来,Bug Squash 这一轮的准备就比较扎实了,剩下的时间用来补 Colander 和 Java 线。
如果想有人陪你按这两套流程各走一遍、并在你卡住时直接指出定位方法上的问题,可以了解我们的VO 辅助(实时):按目标公司轮次匹配有对应经验的导师。
配套阅读:《Stripe Debug / Integration:Follow-up 怎么不改崩》讲的是 Debug 轮里怎么在持续追加的 follow-up 下不改崩代码;《Stripe Integration Round 面经 2026》讲的是另一轮的实际流程与考点。
最后提醒一句:这一轮真正被打分的是过程——复现、假设、验证、最小修复、回归。少修一个 bug 不会毁掉这一轮,但静默乱改会。
FAQ
以下是准备 Bug Squash 时最常被问到的几个问题。
Stripe Bug Squash 是什么形式?多长时间?
通常是 50–60 分钟:给你一个以前没见过的、接近真实开源项目规模的 repository,里面已经植入若干 bug 并附有 failing tests。你要跑测试、读 stack trace、定位调用链、用 debugger 验证假设、做最小修复,再跑测试防回归。考的是陌生代码库里的系统定位能力,而不是从零写算法。
Bug 没修完是不是就挂了?
同学提供的面经多次显示最后一个 bug 往往是 stretch 难度,修不完并不决定评价。有候选人 Bug 1、Bug 2 解决、Bug 3 只找到 root cause 就超时,反馈仍然是这一轮表现很好。相比之下,静默地乱改、说不清判断依据更危险。让面试官看到你每一步的判断依据,比多修一个 bug 更重要。
Bug Squash 现场可以查资料,或者用 AI 吗?
同学提供的面经里,搜索引擎和官方文档通常可以查,AI / Cursor 这类代码补全一般不允许。所以准备阶段的重点应该放在 debugger 熟练度和定位方法论上,而不是依赖补全——依赖补全的人在陌生 repo 里会明显变慢。
Python 线优先准备哪个 repo?
优先级是 Mako ≈ requests 307 > Colander > Failsafe。Mako 考 AST visitor 与 template lookup;requests 307 考 seekable stream 的 cursor 语义与 body 重放;Colander 考 validation error 的聚合与 asdict 的嵌套结构。前两个属于必练。
requests 307 那题最容易错在哪?
最容易错的是用 stream.seek(0) 无脑 rewind。如果调用方传入 stream 时已经读过一部分(例如 data.read(5)),第一次实际发送的就是剩余字节,redirect 重放时也必须只发剩余字节;正确做法是在 prepare 阶段记录 body_position = stream.tell,重发前 seek(body_position)。
Java 面试应该准备哪些 repo?
优先 SnakeYAML(scalar 隐式类型推断,例如 flag: On 没有解析成 Boolean.TRUE)和 Moshi / Jackson(parser、deserializer、null handling、type conversion、nested object parsing),其次是 Failsafe(retry count、attempt number、off-by-one、state reset)。这三类在 2025–2026 同学提供的面经里都有出现。
📋 资料来源与审校说明
新文章首发:基于 2025–2026 同学提供的面经信号、公开复现仓库与候选人复盘,整理 Bug Squash 的轮次机制、高频 repo、固定解题流程与备考优先级。
- GitHub:stripesinterview/debugginground(Stripe debugging round 复现):第三方复现仓库,公开提到 Python 候选人会碰到 test_HTTP_307_ALLOW_REDIRECT_POST_WITH_SEEKABLE 这类 failing test。
- Interview Support Pro 模拟面试复盘:用于总结候选人在 Debug 轮里的高频卡点:不敢下手、静默乱改、说不清 root cause、修完不跑回归测试。
💼 完整服务与价格我们提供 OA 代写($199 起)、VO 辅助($299 起)、VO 代面($499 起) 与 30 分钟免费咨询:按目标岗位、公司与轮次匹配具备相关经验的导师,覆盖 Coding、System Design、ML Design 与 BQ;具体导师与背景以接单前书面确认为准。