💡 核心要点 (Key Takeaways)
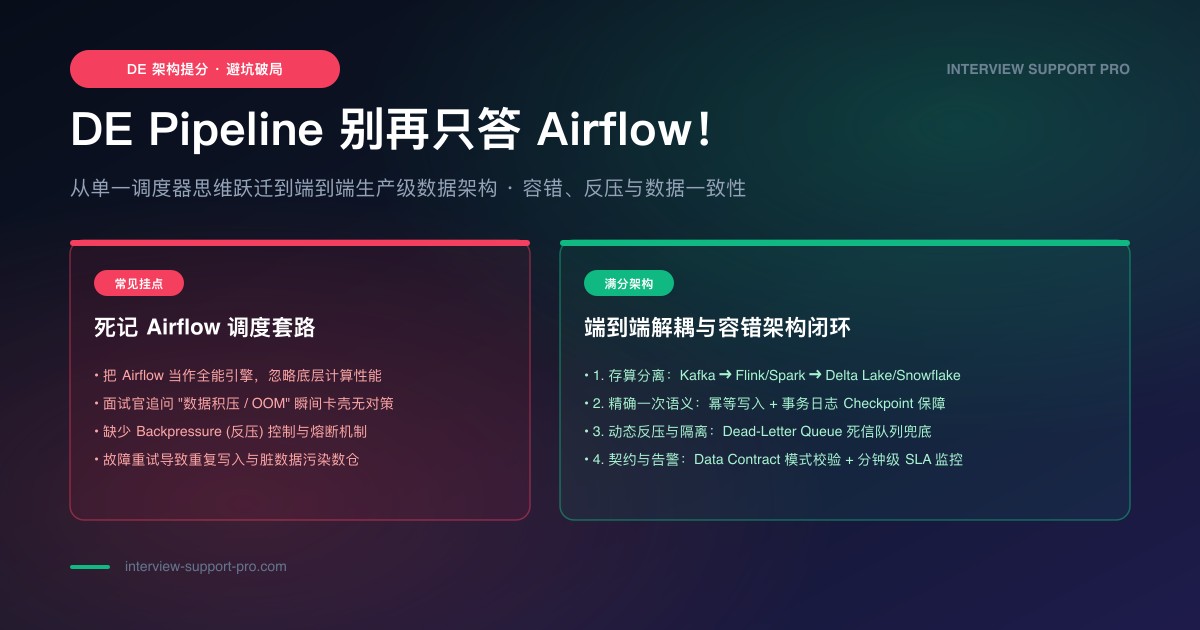
- 只说 Airflow、Spark、Snowflake,会让面试官觉得你只是工具使用者。
- Pipeline design 要按 source、ingestion、storage、transform、quality、serving、observability 讲。
- 回填、幂等、迟到数据和消费方契约是高频追问。
免费获取轮次诊断正在备战 Data Engineer (DE) 面试?免费获取轮次诊断:发你的当前轮次与倒计时,我们先定位卡点,再决定下一步。
原回答长什么样
很多 DE 候选人一讲 pipeline 项目,就会变成工具清单:“我们用 Airflow 调度,用 Spark 处理,用 Snowflake 存储,用 dbt 建模。”这句话没有错,但面试官听不到你解决了什么问题、做了什么判断、如何保证数据可信。
面试官会追问什么
工具清单之后,常见追问会很快进入生产细节:上游 schema 变了怎么办,昨天的数据晚到 6 小时怎么办,回填会不会覆盖线上结果,指标口径改了怎么通知下游,dashboard 异常时谁来判断可信度。
- 迟到数据:watermark、重算窗口、event time 和 processing time。
- Schema:兼容策略、contract test、版本字段和下游公告。
- 回填:资源隔离、幂等写入、结果校验和口径标记。
- 质量:freshness、volume、null ratio、duplicate rate 和 lineage。
改写后的回答
更好的版本可以这样组织:原系统每天从 SaaS API 拉订单数据,下游用于 revenue dashboard;问题是 late update 和重复记录导致收入口径不稳定;我负责把链路拆成 raw、staging、mart 三层,用 source event id 做去重,用 updated_at 和 version 处理增量,用质量检查拦截异常,并给下游暴露口径版本。
💡 如果目标就是 Data Engineer (DE) 岗,按岗位整理的题型分布、轮次路线与准备清单在这里。
Data Engineer (DE) 面试辅助 →自查清单
拿一个自己的 pipeline 项目,先删除所有工具名,只留下业务目标、数据源、建模口径、失败模式、质量检查和下游影响。如果这条主线讲不清,工具名越多越像掩饰。等主线稳定后,再补 Airflow、Spark、dbt、warehouse 这些实现细节。
SLA 和调度窗口怎么讲
「下游报表早上 9 点要看到数据,你的调度怎么设计」是 DE pipeline 题里很实的追问,完整答案分四层。第一层从 deadline 倒推:下游 9 点要数据,减去查询时间和质检时间,才是 mart 层最晚完成时间。第二层给每层留窗口:raw、staging、mart 各自一个窗口加缓冲,单层留 30 到 60 分钟缓冲是常见做法,要说明缓冲依据。第三层讲错过窗口怎么办:下游拿到的是部分数据还是不拿?哪些表可以降级——比如用昨天的数据加 freshness 标记,哪些不行——比如财务口径必须全量。第四层讲 SLA 怎么被发现和沟通:freshness 检查、告警阈值、下游能否自己看到数据新鲜度。回答时避免只说「DAG 凌晨 2 点跑」,那是实现不是设计;面试官要看到的是你能从业务 deadline 倒推、并做降级取舍。练习方法:挑一个自己的 pipeline,把时间线写成一页——每层开始结束时间、缓冲、告警阈值、挂掉时下游看到什么。写不出来,说明没真想过。
数据量涨 10 倍怎么答
「数据量涨 10 倍,你的设计哪里先坏」是高频追问,考的是你对规模瓶颈有没有概念。答案要按层拆,不要笼统说「加机器」。Ingestion 层:API 限流和全量拉取时间可能装不下窗口,要改增量或 CDC,或者分片并行拉取。Transform 层:单分区全表扫描会成为瓶颈,需要分区策略、增量计算、减少跨分区 shuffle。Storage 层:分区和聚簇选择决定查询成本,10TB 时没问题的表,100TB 时查询成本可能失控。Quality 层:检查阈值要随规模重标定,小体量下 0.1% 的重复率无所谓,大体量下就是几万行脏数据。回答的关键是明说「哪层先坏、信号是什么、怎么修」,而不是列一堆扩容手段。练习方法:对自己的项目估算当前数据量和增长速度,逐层回答「多大规模会坏、坏掉时看到什么信号、第一步修什么」。数字不需要精确,推理路径要对。
可直接抄的 DAG 模板:依赖、重试、告警一次配齐
Airflow 部分这道题的常见坑,用一套固定实践就能覆盖,值得背下来。依赖:不要靠时间触发保证顺序,任务之间显式写 depends_on(set_upstream 或 >> 写法),上游失败时下游不会带着空数据跑。幂等:每个任务的写逻辑是「先 truncate 分区再 insert」,重跑不产生重复行,这是挂掉能放心重跑的前提。重试和隔离:对外部不稳定任务(API 拉取、对象存储)设 retries,把长任务拆到独立分支,单分支失败不拖垮整个 DAG。监控:核心任务配 SLA(sla_miss 告警),mart 层加 freshness 检查,告警路由到值班渠道——关键不是发了告警,而是「谁能看到、多快能响应」。回填:口径变更后,回填任务和常规任务用同一份代码,只差日期参数,避免两套逻辑漂移。练习方法:拿自己一个 DAG 按这个模板重写,每个配置写一句「解决什么问题」,写不出来的就是没理解。
📋 资料来源与审校说明
首次发布,提供面试准备方法、题型拆解和复盘建议。 2026-08-21:新增「SLA 和调度窗口怎么讲」「数据量涨 10 倍怎么答」「可直接抄的 DAG 模板:依赖、重试、告警一次配齐」三个 section,补充可执行备考方法。
- 公开面经信号和岗位能力模型:用于归纳题型和常见追问,不复刻候选人私人信息。
- Interview Support Pro 模拟面试复盘:用于总结候选人在表达、项目深挖和 follow-up 中的高频卡点。
💼 完整服务与价格我们提供 OA 代写($199 起)、VO 辅助($299 起)、VO 代面($499 起) 与 30 分钟免费咨询:按目标岗位、公司与轮次匹配具备相关经验的导师,覆盖 Coding、System Design、ML Design 与 BQ;具体导师与背景以接单前书面确认为准。
