💡 核心要点 (Key Takeaways)
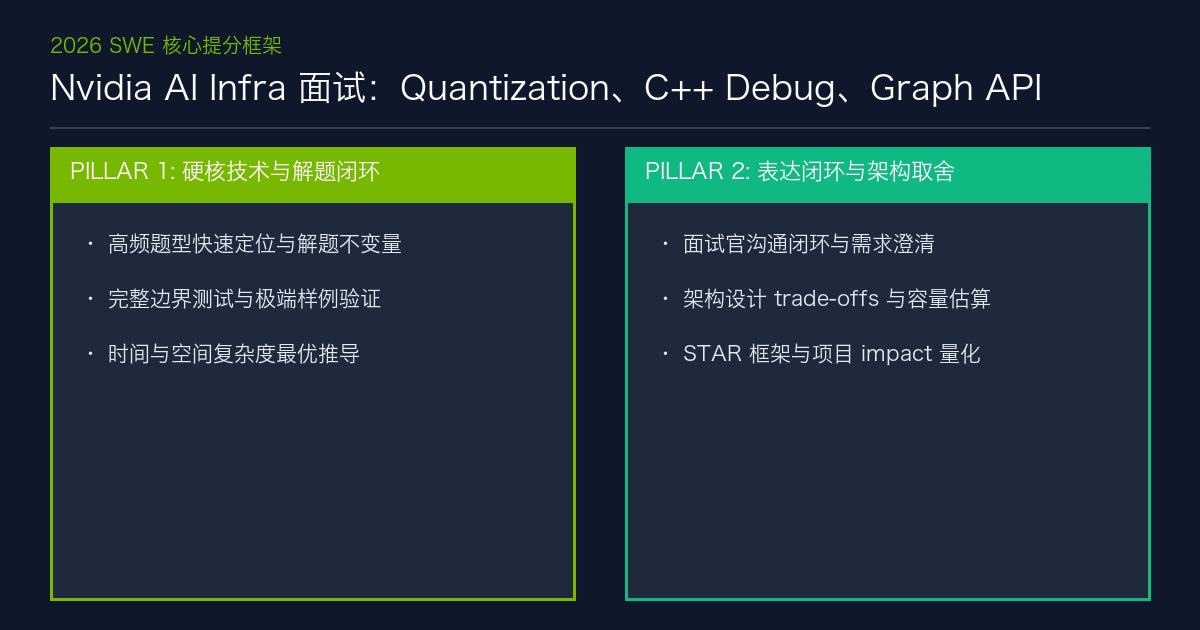
- Nvidia 面试更偏底层、性能、内存、debug 和 AI infra,不适合只刷通用算法。
- Quantization 要讲 scale、zero point、saturation、校准数据和误差。
- C++ / System Software 题要把正确性、性能、ownership 和调试方法一起讲。
免费获取轮次诊断正在备战 Nvidia SWE 面试?免费获取 Nvidia SWE 轮次诊断:发你的当前轮次与倒计时,我们先定位卡点,再决定下一步。
为什么 Nvidia 准备方式不同
Nvidia 的面试信号高度岗位相关。System Software、AI Infra、Deep Learning、DGX 等方向会把算法、系统、C++、硬件意识和项目深度混在一起问。只准备二叉树和数组,覆盖度会明显不够。
Quantization 必须讲到什么程度
INT8 quantization 不能只写 round。你要解释 scale 怎么来,为什么要 clamp,asymmetric quantization 为什么需要 zero point,per-tensor 和 per-channel 有什么取舍,非对称分布和 saturation 会带来什么误差。
Graph API 和 DAG 题怎么答
Graph API insert/configure/validate 本质是 DAG 管理。基础解是 adjacency list、indegree、topological sort、cycle detection;更进一步要讲节点类型、shape/type validation、增量 validate 和错误报告。
💡 Nvidia 的完整准备路线:OA / Phone / VO 各轮考什么、怎么练,公司攻略页整理成了清单。
Nvidia 面试全攻略 →C++ Debug 的训练方法
读已有项目时,不要一上来改代码。先复现问题,再缩小范围,读日志,加断言,用 sanitizer 或线程工具定位 memory bug、race condition 或 logical bug。AI 可以辅助生成猜测,但候选人必须能验证。
项目深挖怎么准备
AI Infra 项目要能讲吞吐、latency、memory、kernel / serving bottleneck、监控、回滚和成本。HM 轮也会关注你如何处理不确定需求、跨团队协作和生产事故复盘。
Memory Allocator 题怎么答
System Software 岗常问 allocator,因为热路径对分配延迟、碎片和锁竞争敏感。答题先澄清 workload:对象大小分布、分配速率、生命周期、线程模型,再选方案,不要直接背 arena。常见方案包括 arena(大块预分配、批量释放)、pool + free list(按 size class 复用)、thread-local cache(减少跨线程竞争)。回答分三步:先说明为什么默认分配器在这个 workload 下不够(全局锁竞争、混合大小导致的碎片),再给方案和代价,最后讲回归风险:内存膨胀、泄漏、对齐错误,以及如何观察它们。
- 澄清优先:大小分布、分配速率、生命周期、线程模型,四问之后再选型。
- 方案对比:arena 零碎片但内存开销高,free list 快但碎片和 use-after-free 风险高,lock-free 有 ABA 和调试成本。
- 结合场景:短生命周期大批量对象适合 arena,长期混合大小适合 size class + free list。
- 验证方法:分配次数、延迟分布、内存 footprint、碎片率,说明你会怎么测量。
- 风险控制:内存膨胀、泄漏排查、对齐错误的观测手段。
高性能 string 与内存布局怎么讲
AI Infra 代码里 graph config、kernel 参数、日志和指标名大量走 string,热路径上的字符串分配会直接影响性能。要能指出 SSO(小串优化)为什么能省堆分配,reserve 和容量翻倍为什么让 append 摊还 O(1),以及解析时用 string_view 做零拷贝为什么比拷贝整段文本好。高频出现的 op 名、属性名适合 interning 去重。再延伸到内存布局:数组 of struct 还是 struct of array、cache line、padding 和 alignment 对扫描性能的影响。答题时把优化落到具体位置:热循环里谁在分配、谁在拷贝、谁在触发 reallocation,并说明验证方式(分配次数、cache miss 率、延迟分布),而不是罗列优化名词。
- 热路径盘点:找出循环里每次迭代都发生分配的字符串操作。
- 零拷贝与预分配:string_view 传参、buffer 预分配,避免 reallocation。
- interning:op 名、属性名、指标名等重复 key 去重。
- 布局意识:SoA/AoS 选择、cache line、对齐,配合 profiling 数据说明收益。
📋 资料来源与审校说明
首次发布,提供面试准备方法、题型拆解和复盘建议。 近期教研更新:新增 Memory Allocator 答题框架、高性能 string 与内存布局 2 个 section,补充 description 提到但正文未展开的题型。
- 公开面经信号和岗位能力模型:用于归纳题型和常见追问,不复刻候选人私人信息。
- Interview Support Pro 模拟面试复盘:用于总结候选人在表达、项目深挖和 follow-up 中的高频卡点。
💼 完整服务与价格我们提供 OA 代写($199 起)、VO 辅助($299 起)、VO 代面($499 起) 与 30 分钟免费咨询:按目标岗位、公司与轮次匹配具备相关经验的导师,覆盖 Coding、System Design、ML Design 与 BQ;具体导师与背景以接单前书面确认为准。
