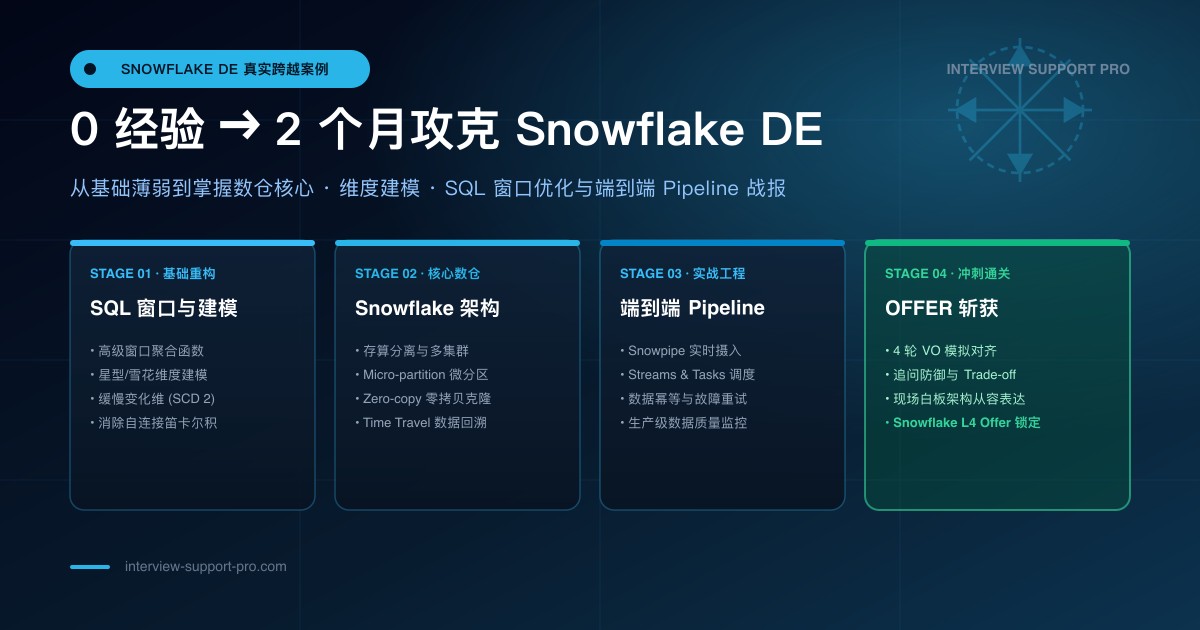
💡 核心要点 (Key Takeaways)
免费获取轮次诊断正在备战 Snowflake Data Engineer (DE) 面试?免费获取 Snowflake Data Engineer (DE) 轮次诊断:发你的当前轮次与倒计时,我们先定位卡点,再决定下一步。
学员背景
传统行业 IT 背景,SQL 熟练但无数据平台经验,自学 dbt + Spark 1 个月,投递 Snowflake DE 岗位。SQL 面试能做对但写不出优雅解法,数据建模只懂 Star Schema 不会拆维度,实时数据流(Kafka/Flink)完全空白。
核心痛点诊断
能力差距分析发现 Snowflake DE 面试 70% 集中在 SQL 优化 + 数据建模 + pipeline 设计。候选人 SQL 能做对但缺少窗口函数、CTE 重构、性能调优等高级技巧,数据建模只懂 Star Schema 不会拆维度,实时数据流完全空白。
- SQL 能做对但写不出优雅解法。
- 数据建模只懂 Star Schema 不会拆维度。
- 实时数据流(Kafka/Flink)完全空白。
2 个月冲刺策略
我们把 2 个月分为三个阶段,每个阶段聚焦不同的 DE 能力。
💡 Snowflake 的完整准备路线:OA / Phone / VO 各轮考什么、怎么练,公司攻略页整理成了清单。
Snowflake 面试全攻略 →结果
Phone Screen SQL 全对,VO 数据建模 + pipeline 设计两轮通过,拿到 offer。学员反馈'模拟面试时导师帮我梳理的 pipeline 设计框架,面试时真的用上了'。
这篇战报该怎么用
如果你也是传统行业想转 DE,建议先做一次能力差距分析,看看自己的 SQL 优化、数据建模和 pipeline 设计能力是否达标。如果只是 SQL 能做对但写不出优雅解法,那你需要的是实战项目补齐数据建模经验,而不是继续刷题。
SQL 性能优化题怎么答
优化类题目在面试里通常是'这条查询慢,你怎么排查',不是让你背参数。准备一个四步回答:先定位瓶颈,按全表扫描、shuffle、数据倾斜三类现象说;再结合执行计划解释原因,比如 join 条件缺失导致笛卡尔积,或者分区列没进谓词导致全分区扫描;然后给具体手段,谓词下推、分区裁剪、处理倾斜 key、把全量改增量、减少中间表数量;最后说怎么验证,对比优化前后的执行时间、扫描字节数和 shuffle 量。回答时不要只报优化术语,每个手段都要挂到一个具体症状上,否则面试官会追问'你怎么确定是这个原因'。数据倾斜这一项单独准备:倾斜 key 先过滤掉再参与 join、给 key 加随机后缀做两阶段聚合、或者把大表广播,这三种手段各准备一句话说明适用场景。回答时再补一句取舍,比如分区裁剪让查询变快,但对分区列的设计要求更严,时间范围不明确的查询裁剪不到,这样显得你不是只会报手段。平时练习时找 3 到 5 条慢查询,完整走一遍四步,把话术练顺;如果没有现成的慢查询,可以自己构造:造一张千万级订单表,故意写出一个倾斜的 join,再按流程把它修掉。修完记得说清楚优化前后的量化差异,'扫描量从全表降到某个分区'比'变快了'有说服力得多。
从 0 到 1 pipeline 设计题怎么组织
被问到'为某类数据设计一条 pipeline'时,很多候选人直接开始选工具,顺序反了。稳定的结构分五步:先问清数据源、更新频率和下游消费者,确认是 T+1 批量还是近实时;再定接入方式,增量变更用 CDC,全量快照就说清成本和延迟的取舍;然后分层,staging 做清洗去重,中间层做实体建模,mart 层面向查询模式;第四步讲可靠性,幂等写入、失败重试和死信处理、回填方案、数据质量监控各说一条;最后主动提成本和演进,计算存储怎么控,新增一个数据源怎么扩展。数据质量监控这一条展开讲:主键唯一性、关键字段空值率、天环比波动超阈值告警,三个监控点各给一句面试话术,面试官听到具体指标会明显加分。讲回填时把'历史数据补录'和'逻辑变更后重算'分开说,两者范围、校验方式都不同,混在一起是常见失分点。工具名字只占一小部分,结构和取舍才是评分点。练习时给自己设 30 分钟,完整口述一遍,录音回放,重点听自己有没有在第一步就跳进工具选型。转 DE 的候选人尤其要练'先问再画',因为面试官就是想确认你不是拿着一个固定模板往所有场景上套。每次口述完对照五步打分,哪一步跳了就补哪一步,两三遍之后结构会稳定下来。
📋 资料来源与审校说明
首次发布,提供面试准备方法、题型拆解和复盘建议。 2026-08-21:新增「SQL 性能优化题怎么答」「从 0 到 1 pipeline 设计题怎么组织」两个 section,补充可执行备考方法。
- 公开面经信号和岗位能力模型:用于归纳题型和常见追问,不复刻候选人私人信息。
- Interview Support Pro 模拟面试复盘:用于总结候选人在表达、项目深挖和 follow-up 中的高频卡点。
💼 完整服务与价格我们提供 OA 代写($199 起)、VO 辅助($299 起)、VO 代面($499 起) 与 30 分钟免费咨询:按目标岗位、公司与轮次匹配具备相关经验的导师,覆盖 Coding、System Design、ML Design 与 BQ;具体导师与背景以接单前书面确认为准。
